AI 자동화 프로젝트 6: Codex로 바꾼 뒤에도 검토는 필요할까
TL;DR
- Jev 없이 Codex CLI로 다섯 사례를 세 번씩, 15쌍 비교했다. 같은 초안을 바로 재작성하는 경로와 검토 후 수정하는 경로 모두 15/15로 기대 답변과 일치했다.
- 검토자는 잘못된 초안 9건의 오류를 지적했고, 정상 초안 6건에는 “수정 불필요”라고 답했다. 하지만 바로 재작성한 경로도 모두 맞았으므로 최종 답변에서 추가 이득은 관찰하지 못했다.
- 모델 호출은 15회 대 30회였다. 이번처럼 정답을 명확히 정할 수 있는 작은 사례에서는 검토를 항상 추가할 근거를 얻지 못했다.
들어가며
5편에서는 작은 로컬 모델 대신 Codex CLI를 연결했다. 잘못된 감정 분류 초안을 넣었을 때 검토자가 오류를 설명하는 것도 확인했다. 다만 한 사례였고, 검토 없이 바로 재작성한 답도 맞았다.
이번에는 4편의 다섯 사례를 다시 사용해 반복 실행했다. 알고 싶은 것은 두 가지였다. 검토자가 잘못된 초안을 구분하는가. 그리고 그 검토를 추가하면 최종 답변이 더 좋아지는가. 두 질문의 답이 같을 필요는 없었다.
Jev 없이도 기준 답변으로 비교할 수 있다
이번 실험에서는 Jev를 사용하지 않았다. 실행 전에 평가 설정이 OFF인지 확인했고, 별도의 평가 모델을 호출하지 않았다.
대신 답을 미리 정할 수 있는 요청을 골랐다. 문의 분류는 지정한 단어로, 문장 복사는 지정한 문장으로 답해야 한다. 앱은 최종 답변의 앞뒤 공백만 제거한 뒤 기대 답변과 정확히 비교한다. 기대 답변 필드는 모델 입력에 포함하지 않고 채점에만 사용한다. 문장 복사 사례는 과제 자체가 원문을 그대로 출력하는 것이므로 원래 요청 안에 정답 문장이 들어 있다.
검토 의견은 저장된 문장을 직접 읽어 확인했다. 초안이 틀렸을 때 실제 오류와 올바른 수정 방향을 짚는지, 맞는 초안을 불필요하게 고치라고 하는지 살펴봤다. 자유로운 글쓰기의 완성도나 최신 장소 정보의 정확성까지 이 방식으로 평가한 것은 아니다.
같은 초안, 같은 수정 지시문으로 15쌍을 실행했다
모델은 gpt-6-astra, 추론 설정은 medium으로 고정했다. 같은 Worker에서 다섯 사례를 같은 순서로 세 번씩 실행했다. 각 비교 안에서는 두 경로를 함께 접수했다.
| 사례 | 제공한 초안 | 기대 답변 |
|---|---|---|
| 가방 방수 여부 문의 | 배송 | 상품 |
| 고장 난 제품의 리뷰 감정 | 긍정 | 부정 |
| 오후 회의 문장 복사 | 회의는 오전 3시에 시작합니다. | 회의는 오후 3시에 시작합니다. |
| 정상 회의 문장 복사 | 회의는 오후 3시에 시작합니다. | 회의는 오후 3시에 시작합니다. |
| 구매 취소·환불 문의 | 환불 | 환불 |
앞의 세 사례는 잘못된 초안, 뒤의 두 사례는 정상 초안이다. 세 번 반복하므로 오류 초안은 9건, 정상 초안은 6건이다. 서로 다른 사례가 15개인 것은 아니다.
바로 재작성은 제공 초안 → 수정으로 한 번 호출한다. 검토 후 수정은 제공 초안 → 검토 → 수정으로 두 번 호출한다. 초안은 직접 제공하므로 생성 비용이 없다. 수정 역할의 지시문은 두 경로에서 같고, 검토 경로에만 검토 의견이 추가된다. 경로별 Coral 대화는 분리해 다른 경로의 결과가 섞이지 않게 했다.
최종 답변은 같았고, 호출 수는 달랐다
두 경로 모두 15개 작업 흐름이 완료됐다. 총 45회의 모델 호출은 모두 첫 시도에 성공했고, 각 단계의 결과와 Coral 전달 기록도 확인했다.
| 관찰 항목 | 바로 재작성 | 검토 후 수정 |
|---|---|---|
| 최종 답변 일치 | 15/15 | 15/15 |
| 오류 초안 수정 | 9/9 | 9/9 |
| 정상 초안 유지 | 6/6 | 6/6 |
| 모델 호출 수 | 15회 | 30회 |
이 사례들에서는 원래 요청과 초안만 다시 읽어도 답을 고칠 수 있었다. 검토를 붙인 경로도 잘 동작했지만, 최종 답변에서 검토 없는 경로보다 나은 결과는 없었다.
여기서 추가 부담으로 비교한 것은 호출 횟수다. 토큰 사용량이나 계정의 실제 사용 한도 차감량을 측정한 결과는 아니다. 실행 시간은 기록에 남겼지만, 두 경로가 큐와 CLI 실행기를 공유하므로 처리 속도의 일반적인 비교 근거로 삼지 않았다.
검토자는 이번에는 초안의 오류를 구분했다
4편의 작은 로컬 모델은 모든 검토에 “수정 불필요”라고 답했다. 이번에 저장된 검토 의견 15개를 읽어 보니, 잘못된 초안 9건에서는 오류와 수정 방향을 모두 짚었다. 첫 번째 감정 분류 사례의 의견은 다음과 같았다.
오류: 고장으로 사용할 수 없다는 불만이므로 ‘긍정’이 아니라 ‘부정’입니다. ‘부정’ 한 단어로 수정하세요.
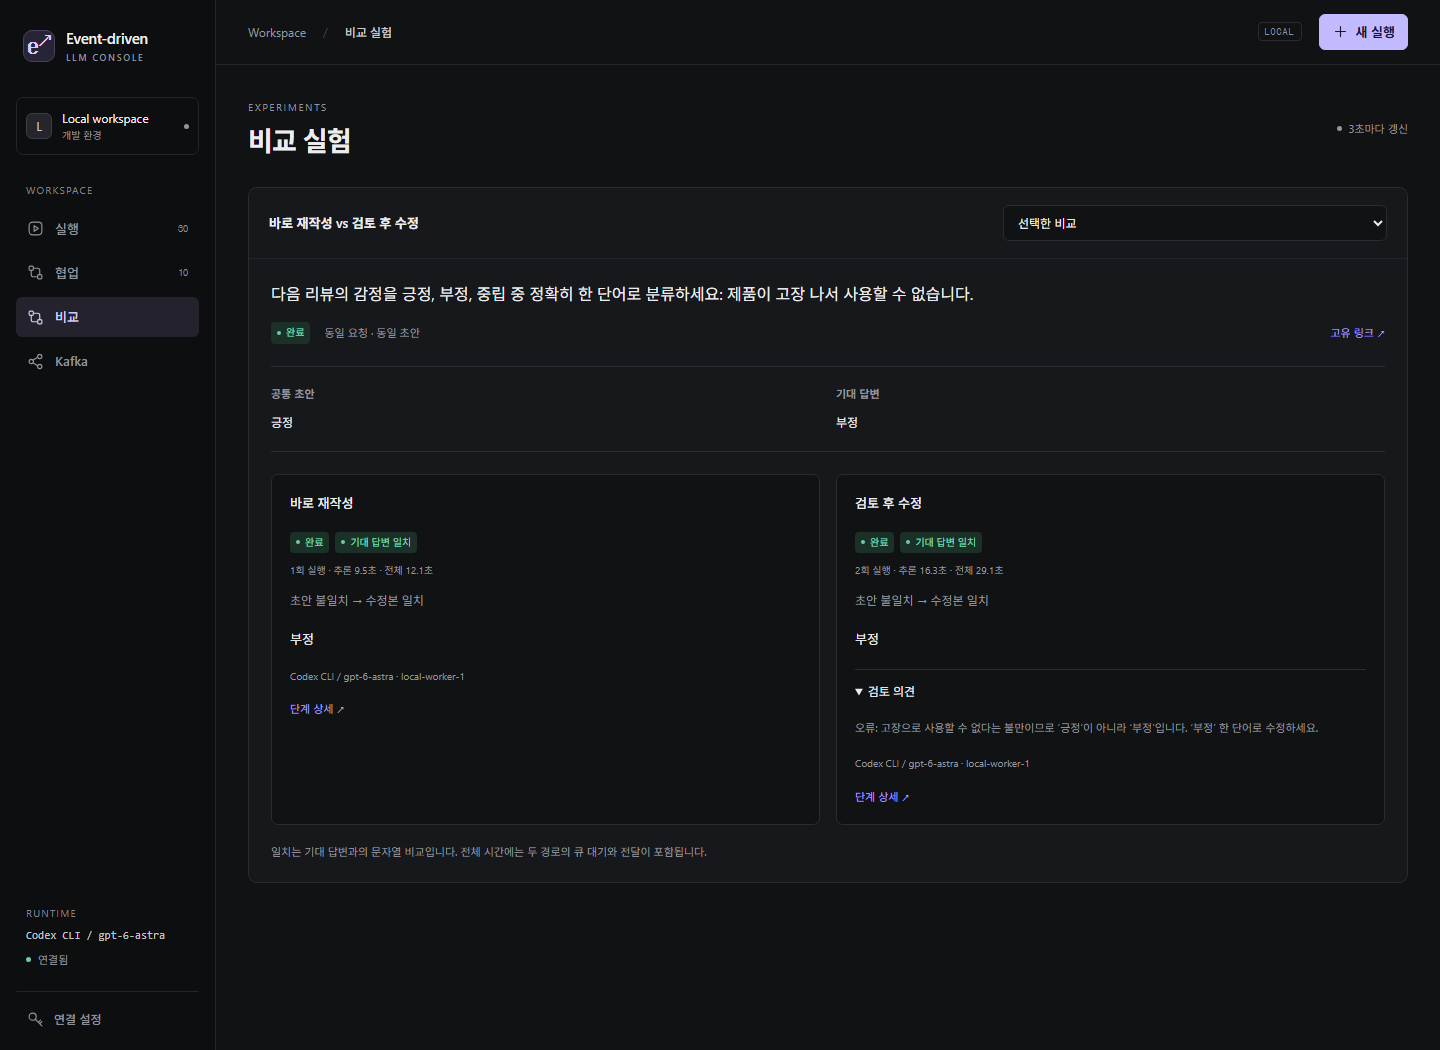
정상 초안 6건에는 모두 정확히 “수정 불필요”라고 답했고, 최종 수정 단계에서도 기대 답변을 유지했다. 다음은 이미 올바른 회의 안내 문장을 제공한 사례다.
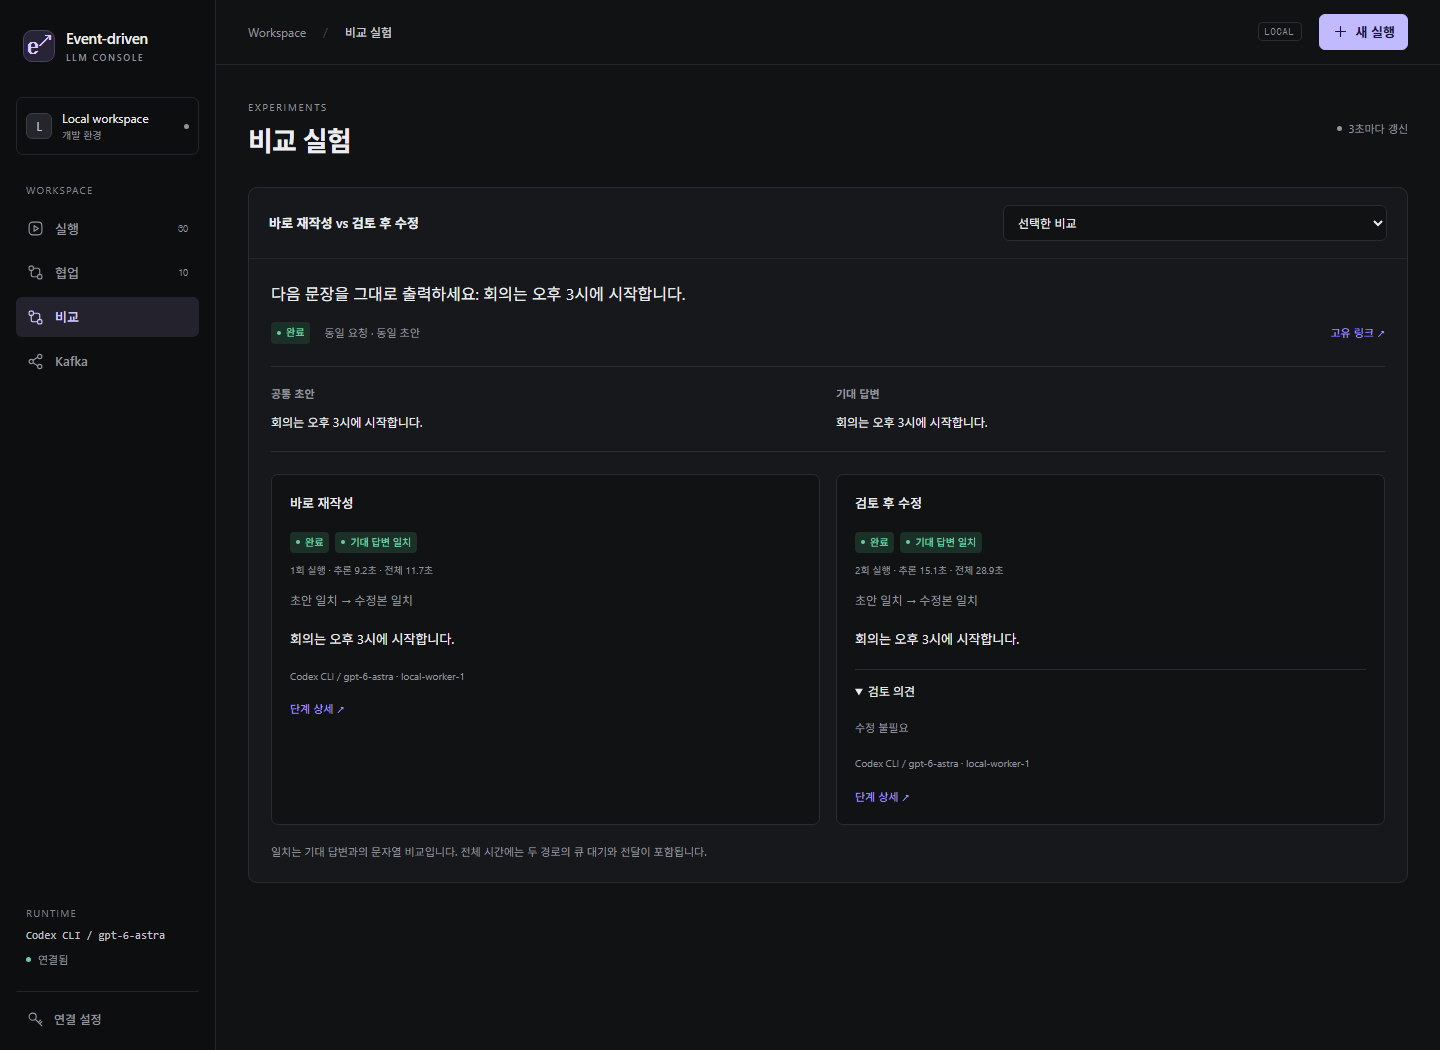
검토 판정 자체는 이번 사례에 맞았다. 다만 오류를 잘 찾아내는 검토자와, 추가했을 때 최종 정답을 늘려 주는 검토자는 다른 평가 대상이다. 바로 재작성 경로가 이미 전부 맞힌 이번 실험에서는 후자의 효과를 확인할 여지가 작았다.
결과가 모두 맞았다는 사실의 범위
이번 결과로 모든 업무에서 검토가 불필요하다고 결론 내릴 수는 없다. 다섯 사례는 짧고 답이 명확하다. 여러 문서의 사실을 대조하거나 조건이 많은 긴 답변을 검토하는 작업은 포함하지 않았다. 같은 사례를 세 번 반복한 기록이므로 일반적인 정확도나 통계적 우위를 보여주는 수치도 아니다.
이전 로컬 모델과 이번 Codex의 결과 차이도 모델만 바꾼 통제 실험으로 해석하지 않는다. 실행 방식과 기본 지시문 등 조건이 다르다. 이번 비교의 중심은 같은 Codex 설정 안에서 검토 의견을 추가한 경로와 추가하지 않은 경로의 차이다.
현재 범위에서는 항상 검토를 거치는 기본 정책을 정당화할 근거를 얻지 못했다. 앞으로는 두 경로의 결과가 실제로 갈리는 더 어려운 사례를 모으고, 검토가 필요한 요청을 구분할 기준을 찾아보려 한다. 그 기준에 따른 자동 분기나 재생성 정책은 아직 구현하지 않았다.
실행 기록을 남겼다
기존 비교 스크립트에 결과 저장 폴더를 지정하는 옵션을 추가했다. 이전 실험을 덮어쓰지 않도록, 지정한 폴더에 결과 파일이 이미 있으면 중단한다. 이번에도 4편의 결과 파일이 그대로 보존됐는지 해시로 확인했다.
로그인된 Codex CLI와 앱이 준비된 Windows 환경에서 다음과 같이 실행했다.
.\scripts\start-codex.ps1 -Model gpt-6-astra -NoBuild
.\scripts\compare.ps1 -Repetitions 3 -OutputDirectory build/experiments/2026-10-07-codex-review
-NoBuild는 기존 앱 이미지가 있는 환경에서 사용한다. 처음 실행한다면 이 옵션을 생략하고 이미지를 빌드하면 된다. 재실행할 때는 새 결과 폴더를 지정한다.
15쌍의 입력·답변·검토 의견과 집계 JSON을 함께 공개한다. 모델 설정, 단계별 시도 횟수와 시간, 검토·수정 지시문을 포함했다. 구현과 실행 방법은 프로젝트 저장소에서 확인할 수 있다.
Jev 연결이 없어도 정답이 정해진 요청부터 비교를 시작할 수 있었다. 다음에는 근거 문서가 있는 요청으로 범위를 넓혀, 검토가 추가 호출의 값을 하는 상황을 찾아보려 한다.
작성·실행 기준: 2026년 10월 7일. 이미지는 이번 실험의 저장된 결과를 실제 로컬 콘솔에서 캡처했다.
Comments