프로젝트 구조를 먼저 정한 이유: 개발 기준과 근거 위키
TL;DR
engineering-standards는 프로젝트마다 선택해 쓸 개발 기준과 에이전트 지침 템플릿입니다. 공통 원칙, 언어 프로필, 프레임워크 프로필을 구분합니다.kdk-knowledge는 공개 저장소의 코드와 설정을 읽고 근거를 연결한 중앙 위키입니다. 현재는 위키 Markdown에서 추출한 Graphify 지식 그래프도 함께 공개합니다. 원본 저장소마다 위키가 있어야 하는 구조는 아닙니다.- 기준 문서는 어떻게 만들지, 근거 위키는 공개 코드에서 무엇을 확인했는지를 다룹니다. 어느 프로젝트에 기준이 실제 적용됐는지는 별도 기록이 필요합니다.
- 두 저장소의 목적은 에이전트에게 명확한 작업 경계를 주면서도, 사람이 구조와 코드를 다시 따라 읽게 하는 것입니다.
이 글의 순서
- 왜 기준과 근거를 나눴는가
- 개발 기준을 선택하고 소비 프로젝트에 적용하는 흐름
- Spring 요청을 따라 읽는 예시
- 공개 소스가 중앙 위키가 되는 흐름
- 현재 한계와 다음에 확장할 자리
들어가며
프로젝트 구조를 정할 때 에이전트가 어디에 코드를 놓을지만 생각하면 부족합니다. 시간이 지난 뒤 사람이 요청이 들어오는 곳부터 처리, 저장, 응답, 테스트까지 따라갈 수 있어야 하고요. 새 프로젝트를 시작할 때마다 같은 기준을 처음부터 설명하는 대신, 필요한 부분을 골라 가져갈 수 있으면 좋겠습니다.
이 문제를 두 종류의 기록으로 나눴습니다. engineering-standards는 앞으로 코드를 만들 때 선택할 기준이고, kdk-knowledge는 공개된 프로젝트의 실제 소스에서 확인한 내용을 모으는 위키입니다. 아래 설명은 두 저장소의 공개 파일을 기준으로 합니다. 예시로 만든 소비 프로젝트는 실제 적용 실적이 아니라 구조를 읽기 위한 가상 사례입니다.
왜 기준과 근거를 나눴을까요?
두 저장소가 답하는 질문이 다릅니다.
- 다음 프로젝트에서 어떻게 만들까?
engineering-standards에서 이름, API 계약, 오류, 테스트의 기준을 찾습니다. 소비 프로젝트에는 선택한 언어·프레임워크 프로필을 따로 기록합니다. - 이 공개 프로젝트는 실제로 어떻게 동작하나?
kdk-knowledge에서 코드와 설정을 읽고, 어느 파일을 어느 커밋에서 확인했는지 연결합니다. - 왜 그런 선택을 했나? 코드에 보이는 구현만으로는 이유를 알 수 없습니다. 공개 가능한 결정 기록이 있을 때 사실과 구분해 연결합니다.
기준을 모아두면 프로젝트마다 같은 출발점을 재사용할 수 있습니다. 하지만 기준 저장소가 존재한다는 이유만으로 기존 프로젝트에 규칙이 적용되지는 않습니다. 반대로 위키의 설명을 앞으로 만들 모든 코드의 강제 규칙처럼 읽어도 곤란합니다. 선택할 규칙과 관찰한 사실을 분리해야 둘 다 정확하게 갱신할 수 있습니다.
이 구분은 사람에게도 필요합니다. 코드를 볼 때는 “이 파일이 무슨 책임인가”를 먼저 찾아야 하고, 과거 프로젝트를 설명할 때는 “그 말의 근거 파일이 어디인가”로 돌아갈 수 있어야 하니까요.
개발 기준: 공통 원칙에서 소비 프로젝트 지침까지
그림 1. 공개 저장소의 적용 안내를 바탕으로 그린 개념 흐름도입니다. 특정 소비 프로젝트가 이미 이 순서로 적용됐다는 뜻은 아닙니다. 그림을 누르면 원본 크기로 볼 수 있습니다.
README의 문서 지도를 실제 경로로 줄이면 다음과 같습니다.
engineering-standards/
├── standards/                 # core, naming, architecture, api-dto, transactions
├── profiles/languages/       # java, python, dart, csharp, typescript
├── profiles/frameworks/      # spring-boot와 새 프로필 템플릿
├── agents/implementation.md  # 요구 → 구현 → 검증 결과
└── templates/                # 소비 프로젝트용 AGENTS.md와 project-profile.md
무엇을 공통으로 두고, 무엇을 선택하나요?
공통 원칙은 요구사항과 수용 조건을 먼저 확인하고, 예상 가능한 오류를 성공처럼 감추지 않으며, 테스트 기대값을 구현과 독립적으로 만들라고 합니다. 명명 규칙은 timeoutSeconds처럼 의미와 단위를 드러내라고 합니다. 그래서 사람이 이름만 보고도 데이터가 무엇인지, 어디서 쓰는지 짐작할 수 있습니다.
API를 다룰 때는 API·DTO 계약에서 필수·선택 필드, null과 빈 값, 상태·오류, 재시도 조건을 고릅니다. DB를 다룰 때는 트랜잭션 가이드에서 함께 성공·실패해야 할 변경과 실제 DB의 동시성 검증 범위를 확인합니다. 모든 작업에 같은 DTO 수나 격리 수준을 강제하는 문서는 아닙니다.
표기와 폴더 관례는 사용하는 언어의 프로필이 맡습니다. 예를 들어 Python은 find_entry와 test_entry_parser.py처럼 snake_case를 쓰고, Dart은 함수의 lowerCamelCase와 파일의 lowercase_with_underscores를 구분합니다. C#의 공개 타입·메서드 PascalCase와 인터페이스 I 접두사는 C# 범위의 관례입니다. TypeScript은 함수 camelCase, 파일은 프로젝트가 고른 형식을 사용하며 기본 제안은 kebab-case입니다. Java도 별도 언어 프로필에 둡니다.
공통으로 지킬 것은 같은 개념에 같은 이름을 쓰고, 요구와 검증을 연결하는 일입니다. Java식 패키지나 Spring 계층을 Python·Dart·C#·TypeScript에 그대로 복제하는 일은 공통 규칙이 아닙니다. 작은 Python 모듈을 굳이 네 계층으로 쪼개거나, TypeScript에 C#의 I 접두사를 강요하지 않습니다. 구조 선택 가이드도 작은 기능에서 빈 인터페이스와 폴더를 미리 늘리지 말라고 합니다.
실제 프로젝트에 가져갈 때 채우는 파일
적용 안내는 기준의 고정 커밋 문서 트리를 소비 프로젝트의 docs/engineering-standards/에 복사하도록 안내합니다. 문서 간 상대 링크를 유지하기 위해 전체 트리를 가져오지만, 에이전트가 매번 모든 문서를 읽어야 한다는 뜻은 아닙니다. 이미 같은 경로가 있으면 덮어쓰기 전에 차이를 봅니다.
소비 프로젝트의 루트 AGENTS.md 템플릿에는 기존 계약 위치, 선택한 규칙의 프로젝트 내부 경로, 코드 진입점, 실제 빌드·테스트 명령을 채웁니다. docs/engineering-profile.md 템플릿에는 기준 커밋, 선택과 제외, 기존 관례와 충돌하는 부분, 예외, 요청 → 처리·정책 → 저장·외부 연동 → 응답 → 테스트의 읽기 지도를 적습니다. 기존 루트 지침이 있으면 교체하지 않고 필요한 부분을 합칩니다.
에이전트에게는 이 지침과 함께 이번 작업의 범위·입력·출력·수용 조건을 전달합니다. 구현 지침은 결과에 요구사항 → 파일·심볼 → 테스트의 연결, 변경 이유, 실행한 명령과 통과/실패/미실행 구분을 남기게 합니다. 기준이 코드 작성에서 끝나지 않고 사람이 결과를 읽는 데까지 이어지는 부분입니다.
가상 Spring 요청 하나를 따라가 봅시다
Spring Boot 프로필의 presentation / application / domain / infrastructure는 새 Spring 프로젝트의 기본 선택안입니다. 아래 CatalogEntry는 프로필의 설명용 도메인을 따른 개념 예시입니다. 어떤 공개 프로젝트의 실제 엔드포인트나 성과를 설명하는 예가 아닙니다.
POST /catalog-entries로 항목을 하나 만든다고 가정해보겠습니다. 사람이 코드를 읽는 순서로 책임을 따라가면 이렇습니다.
presentation— 입력과 응답. Controller와 Request DTO에서 HTTP 입력을 검증하고 작업을 호출합니다.title이 없거나 비었을 때의 응답, 성공 상태와 Response DTO도 이 경계의 계약입니다.application— 작업 순서.CreateCatalogEntryService가 생성 작업과 트랜잭션 경계를 조정합니다. 저장 경계를 분리할 필요가 있으면EntryStore같은 계약을 둡니다. 여기서는 무엇이 함께 성공해야 하는지 확인합니다.domain— 변하지 않아야 할 규칙.CatalogEntry가 항목 상태와 불변식을 표현합니다. HTTP 필드 표기와 무관하게 지켜야 할 규칙이 무엇인지 읽습니다.infrastructure— 실제 연동.JpaEntryStore가 저장 계약을 DB 접근으로 연결합니다. 사용한 저장 기술과 실패를 다루는 지점을 확인합니다.- 테스트 — 확인한 범위. 도메인 규칙, 사용 사례, HTTP·저장 경계를 필요한 만큼 검증합니다. 모형 테스트와 실제 DB 통합 검증 결과를 구분합니다.
호출 흐름으로 보면 Controller가 작업을 부르고 작업이 도메인 규칙과 저장 계약을 사용합니다. 의존 방향은 단순히 네 폴더를 일렬로 잇는 것과 다릅니다. 프로필의 기본 방향은 presentation → application → domain이고, DB 구현인 infrastructure는 필요할 때 application의 저장 계약에 연결됩니다. 요청을 읽을 때는 입력 DTO에서 시작하고, 응답을 확인할 때는 다시 presentation의 응답 계약으로 돌아옵니다.
작은 CRUD라면 모든 클래스에 인터페이스를 만들거나 빈 계층을 채울 이유가 없습니다. 기존 Spring 프로젝트가 기능별 controller/service/repository/dto 구조를 쓰면 그 구조를 먼저 존중합니다. 계층 선택의 목적은 폴더 개수가 아니라 책임과 변경 이유를 추적할 수 있게 하는 것입니다.
공개 소스는 중앙 위키에서 어떻게 기록될까요?
그림 2. kdk-knowledge의 파일과 생성 경로를 그린 구조도입니다. 사람이 등록한 편집 관계와 Graphify가 위키 Markdown에서 추출한 관계를 구분합니다. 그림을 누르면 원본 크기로 볼 수 있습니다.
kdk-knowledge의 편집 원본은 docs/wiki/*.md입니다. docs/wiki/sources.json에는 공개 파일 URL과 전체 커밋 SHA를 등록합니다. 문서 갱신 절차는 README만 보고 설명을 끝내지 말고 구현 코드, 설정, 의존성, 테스트 파일도 읽으라고 합니다. 원본 저장소에 위키가 없어도 이 중앙 위키에 문서를 만들 수 있고, 원본 프로젝트는 수정하지 않습니다.
kdk-knowledge/
├── docs/wiki/*.md          # 사람이 편집하는 프로젝트·기술 설명
├── docs/wiki/sources.json  # 고정 커밋의 공개 근거
├── docs/graph/graph.json   # Graphify 추출 결과를 커밋한 파일
├── scripts/sync_graph.py  # 그래프 결과와 뷰어를 공개 경로로 복사
├── scripts/build_wiki.py  # Markdown + 그래프 → 정적 산출물
└── site/
    ├── wiki/               # HTML 문서와 Markdown 사본
    ├── search-index.json   # 본문 검색용 데이터
    ├── knowledge.json      # 문서·출처·편집/추출 관계
    └── graph/              # 검색·노드 정보가 있는 그래프 화면
생성기는 문서의 메타데이터와 본문을 읽어 위키의 HTML·Markdown 사본, 본문 검색 색인, knowledge.json을 만듭니다. 지금은 docs/graph/graph.json도 읽어 추출 개념과 관계를 합칩니다. 검증 코드는 등록된 URL의 저장소·경로·커밋 형식과 관계 근거를 확인합니다. 문장의 의미가 원본과 일치하는지까지 자동으로 판정하지는 않습니다.
실제 공개 그래프 화면
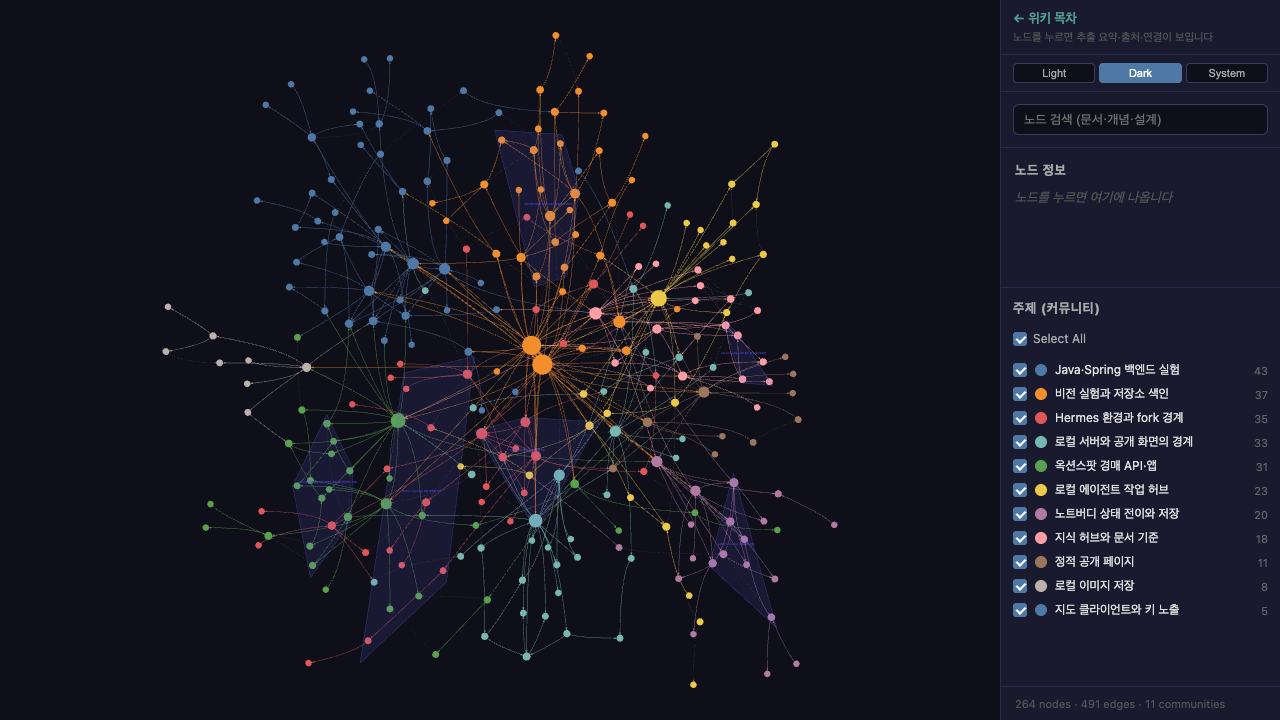
그림 3. 2026년 10월 28일 공개 지식 그래프의 실제 화면 캡처입니다. 이미지를 누르면 그래프가 열립니다. 노드를 고르면 추출 요약과 출처·연결을 살펴볼 수 있습니다.
현재 README와 동기화 스크립트에 따르면 Graphify는 이 저장소의 docs/wiki/*.md를 입력으로 작성자 환경에서 실행합니다. 추출 결과는 docs/graph/graph.json에 커밋하고, 내보낸 뷰어에 검색·노드 정보 패널을 붙여 site/graph/에 게시합니다. 그래서 방문자가 보는 것은 저장된 그래프 화면입니다. 원본 저장소 전체를 방문할 때마다 다시 분석하는 기능은 아닙니다.
사실, 해석, 미확인을 나눠 적습니다
예를 들어 이 위키 자체를 설명한다면 다음처럼 경계를 나눌 수 있습니다.
- 소스에서 확인한 사실:
build_wiki.py가 Markdown에서search-index.json과knowledge.json을 생성합니다. 해당 코드와 고정 커밋을 연결합니다. - 그 사실에서 읽은 구조: 한 편집 원본이 문서·검색·관계 화면에 쓰입니다. 코드의 출력 경로를 근거로 한 해석이라고 밝힙니다.
- 아직 확인하지 못한 것: 각 프로젝트의 선택 이유, 개인 담당 범위, 운영 결과는 별도 공개 근거가 생길 때까지 단정하지 않습니다.
원본에 테스트 파일이 있다는 사실과 그 테스트가 실제로 성공했다는 사실도 다릅니다. 위키는 출처를 가까이 두고 이 차이를 설명해야 합니다. 관계도 두 층입니다. 문서 머리에 사람이 등록한 편집 관계와 Graphify가 위키 Markdown에서 만든 추출 관계를 origin으로 구분합니다. 추출된 연결은 문서의 의미를 탐색하는 단서이며, 공개 원본 코드나 결정 이유를 사람이 검증했다는 표시가 아닙니다. engineering-standards에서 사이트 생성기 코드를 분석한 Graphify와도 입력 범위가 다릅니다.
원본이 바뀌면 무엇을 다시 하나요?
새 공개 커밋이 생겨도 위키 문장이 저절로 갱신되지는 않습니다. 먼저 변경된 README·코드·설정을 다시 읽어 예전 설명이 유지되는지 확인합니다. 필요한 경우 sources.json의 출처를 새 고정 커밋으로 바꾸고, 해당 docs/wiki/*.md의 사실·링크·관계를 함께 고칩니다. 그 뒤 Graphify 추출 결과가 필요하면 다시 생성해 동기화하고, 위키 생성기와 검증 명령을 실행해 산출물을 대조합니다. 문서 갱신 절차에는 이 순서와 build_wiki.py --check, validate.py, 단위 테스트가 적혀 있습니다.
개발 기준을 위키에서 소개하더라도, 다른 프로젝트가 그 규칙을 실제로 채택했다고 표시하려면 그 프로젝트의 적용 문서와 커밋이 필요합니다. 참고 자료로 연결된 것과 적용된 것은 별개입니다.
현재 구조의 한계와 다음에 확장할 자리
이 구조는 기준과 근거를 찾는 길을 만듭니다. 대신 사람이 해야 할 판단을 없애지는 않습니다.
- 기준의 적용은 선택형입니다. 소비 프로젝트의 계약과 기존 관례를 먼저 읽고, 필요한 언어·프레임워크 문서만 고릅니다. 새 스택에 규칙이 필요하면 해당 프로필을 더할 수 있지만, 이미 있는 프로젝트를 일괄 이동하는 근거가 되지는 않습니다.
- 위키의 해설은 수동으로 대조합니다. 소스 URL과 커밋을 검사할 수 있어도 “이 설명이 실제 코드를 제대로 해석했나”는 사람이 다시 읽어야 합니다. 새 사실이나 공개 가능한 결정 기록이 생기면 해당 문서에 범위를 밝혀 보강할 수 있습니다.
- 추출의 범위를 구분합니다. 현재 Graphify는 위키 Markdown을 입력으로 개념과 관계를 추출하고, 그 결과를 저장해 공개합니다. 외부 LLM이 방문 때마다 공개 저장소 전체를 분석하거나 개인의 역할·경력·결정 이유를 자동으로 확정하는 기능은 아닙니다.
제가 중요하게 보는 결과는 디렉터리 모양을 통일하는 일이 아닙니다. 에이전트에게는 작업 범위와 검증 기준을 분명히 주고, 사람에게는 코드의 읽는 순서와 판단의 출처를 남기는 일입니다. 선택할 개발 기준과 공개 근거를 읽는 위키를 분리해 둔 이유도 여기에 있습니다.
Comments